
AI Development
Costruire il tuo agente AI in locale con un LLM: quello che nessuno ti dice
Far girare un LLM o un agente AI in locale con Ollama (Gemma 4) su Mac o Raspberry Pi è possibile, ma ha un soffitto di risorse reale, modelli che sbagliano di più e un function calling fragile. Test alla mano, ecco cosa nessuno ti dice prima.
Franco Tampieri
· 17 min di lettura
La promessa e la domanda vera
C'è una frase che gira in ogni thread, ogni video, ogni post: "Fatti il tuo agente AI in locale: privato, sotto il tuo controllo, senza pagare nessuno." È seducente, ed è anche tecnicamente possibile. Oggi con Ollama o LM Studio scarichi e fai girare un LLM in locale, un modello aperto come Gemma 4, in cinque minuti, ci metti sopra un framework come OpenClaw o Hermes, e hai un agente che gira sulla tua macchina.
La domanda però non è "si può fare?". Sì, si può. La domanda è: cosa succede davvero quando lo fai, e cosa nessuno ti racconta prima.
Ho provato a costruirlo sul serio, sul mio MacBook Air M4 con 24 GB di memoria unificata, una macchina tutt'altro che entry-level. Setup minimo, peraltro: Ollama l'ho installato con un solo comando via Homebrew (brew install ollama), poi ollama pull gemma4:12b e via. Questa è l'analisi onesta di cosa ho trovato. Non per scoraggiare: per arrivarci preparati.
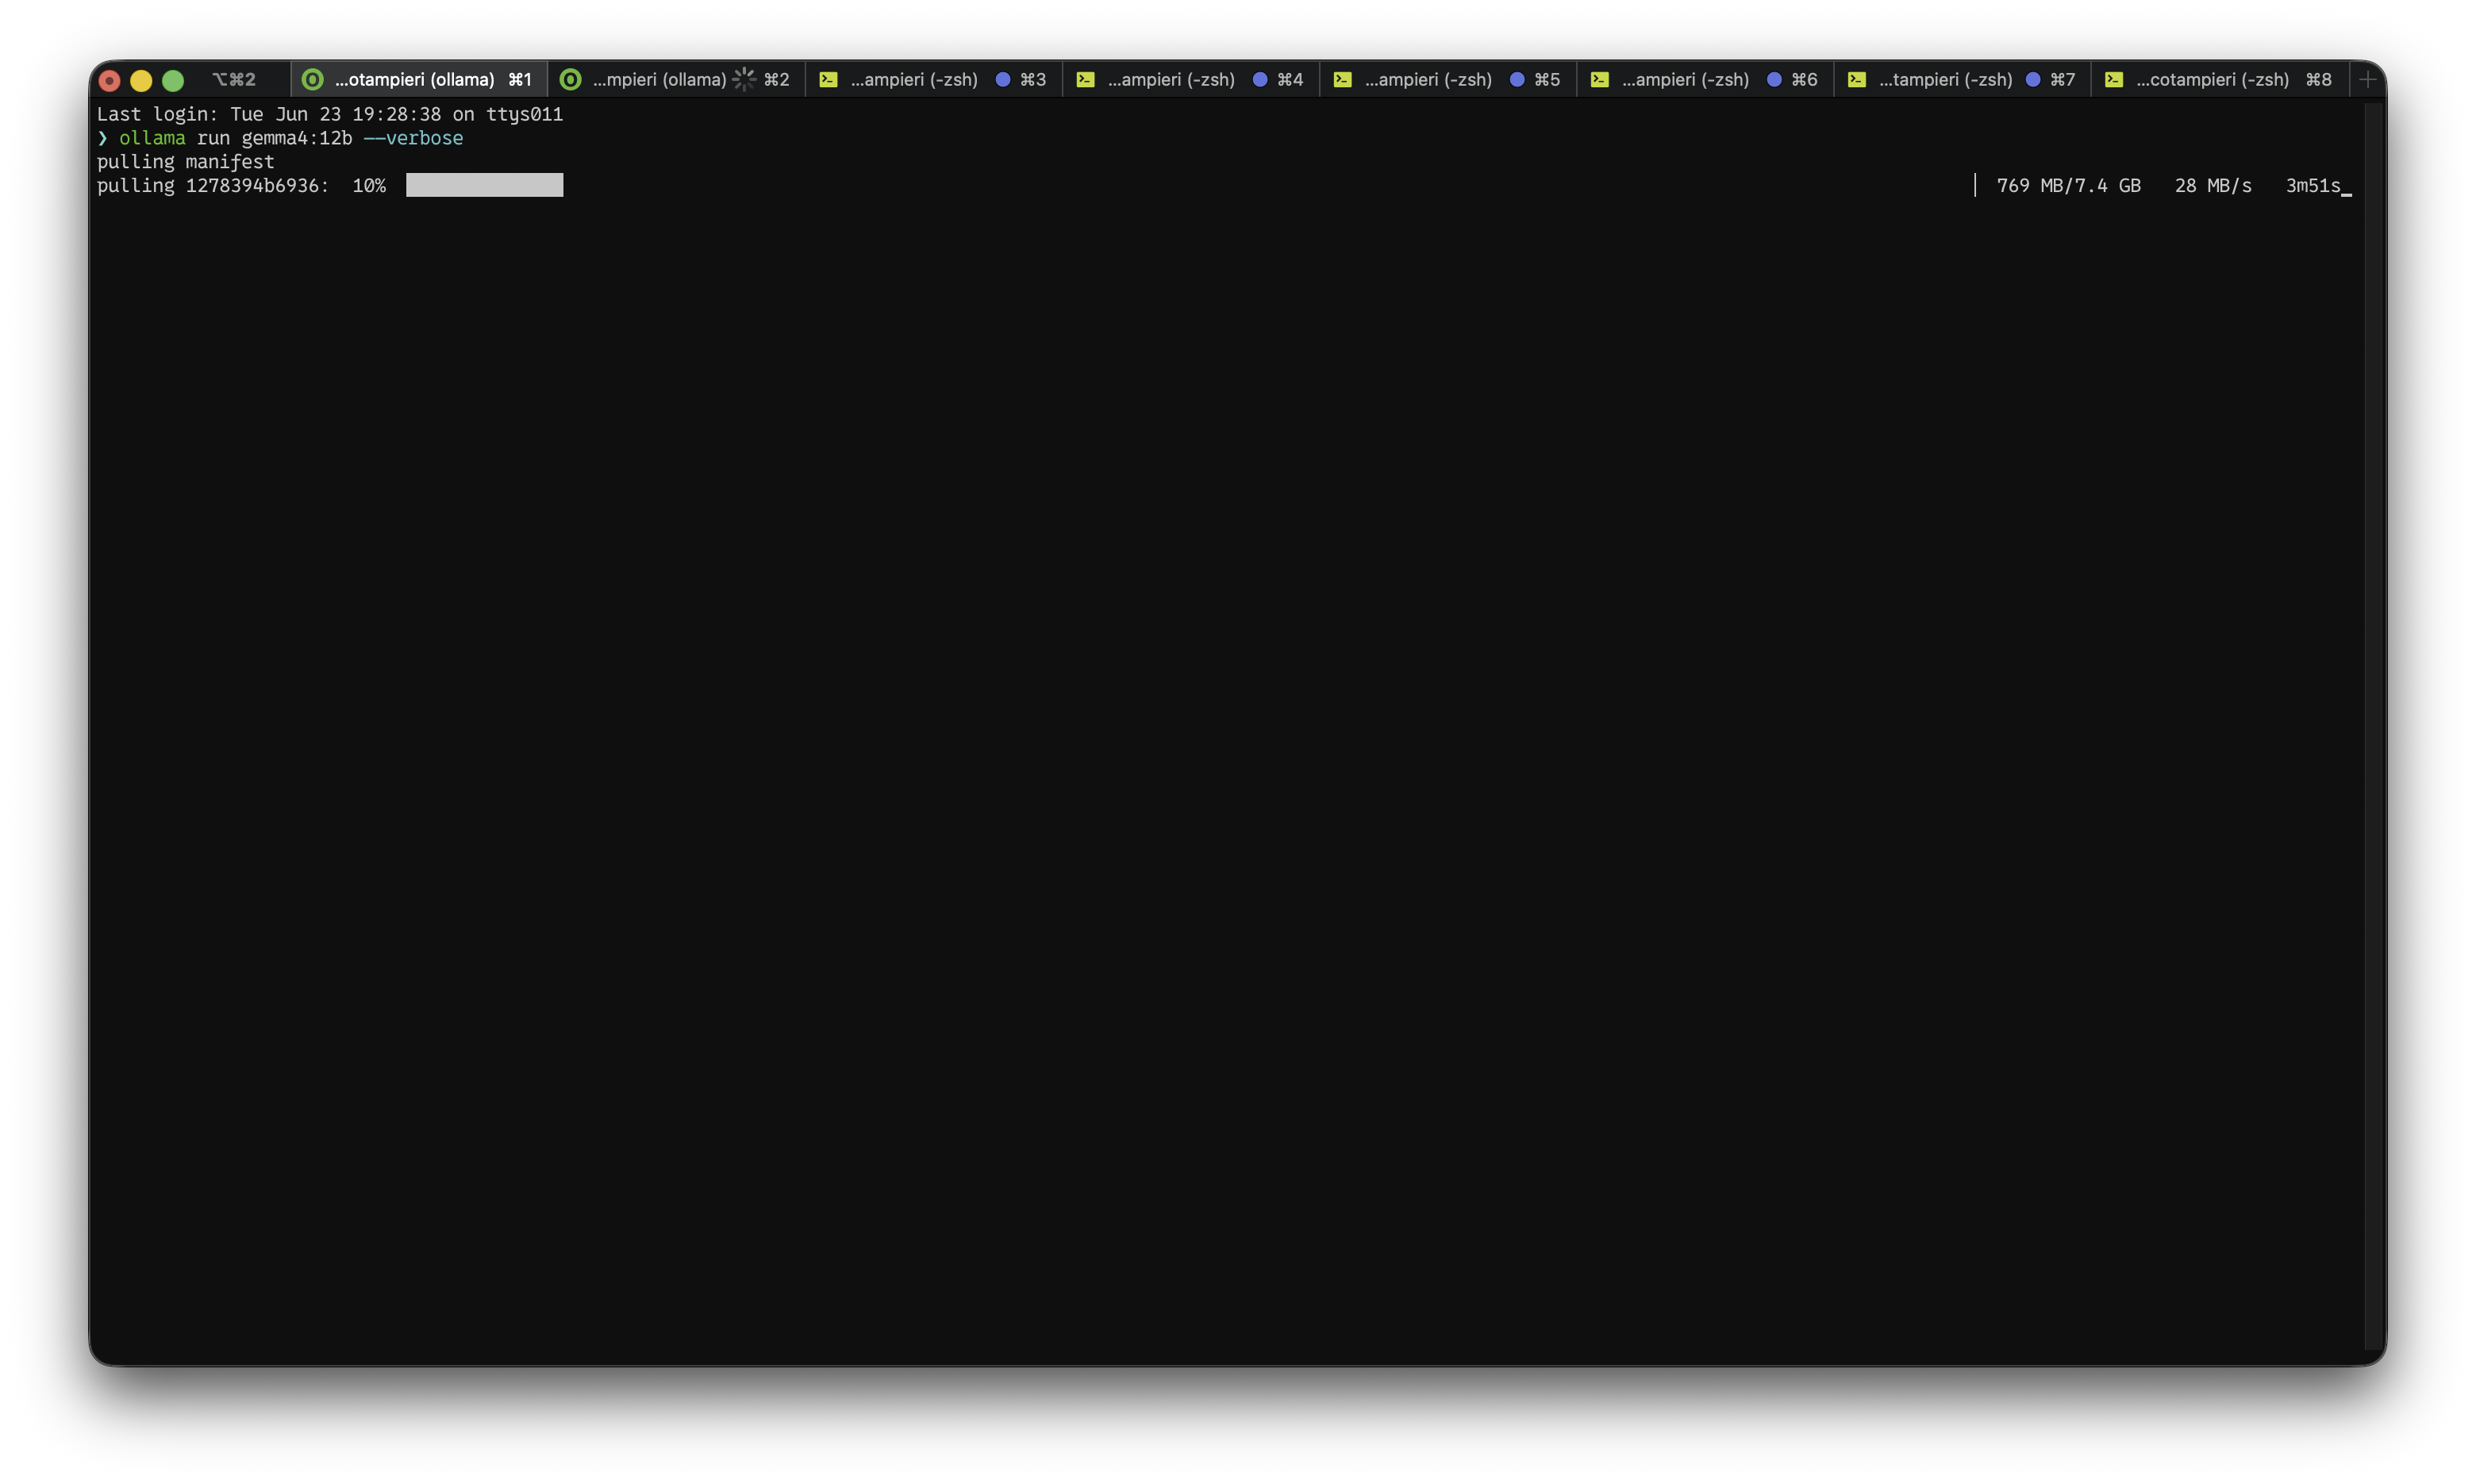 Il punto di partenza: scaricare
gemma4:12b sono 7,4 GB.
Problema 1: la RAM è solo la punta dell'iceberg
Tutti guardano la RAM. È la metrica giusta da cui partire, ma è la più visibile, non l'unica che conta.
Su Apple Silicon la GPU (Metal) può usare circa il 75% della memoria unificata: sui miei 24 GB sono ~18 GB teorici, che diventano ~14-16 GB reali lasciando respiro al sistema e alla cache del contesto. Con quel budget, Gemma 4 12B in Q4 gira comodo; il 26B MoE entra di misura; il 31B denso, il modello di punta, è già al limite dell'impraticabile.
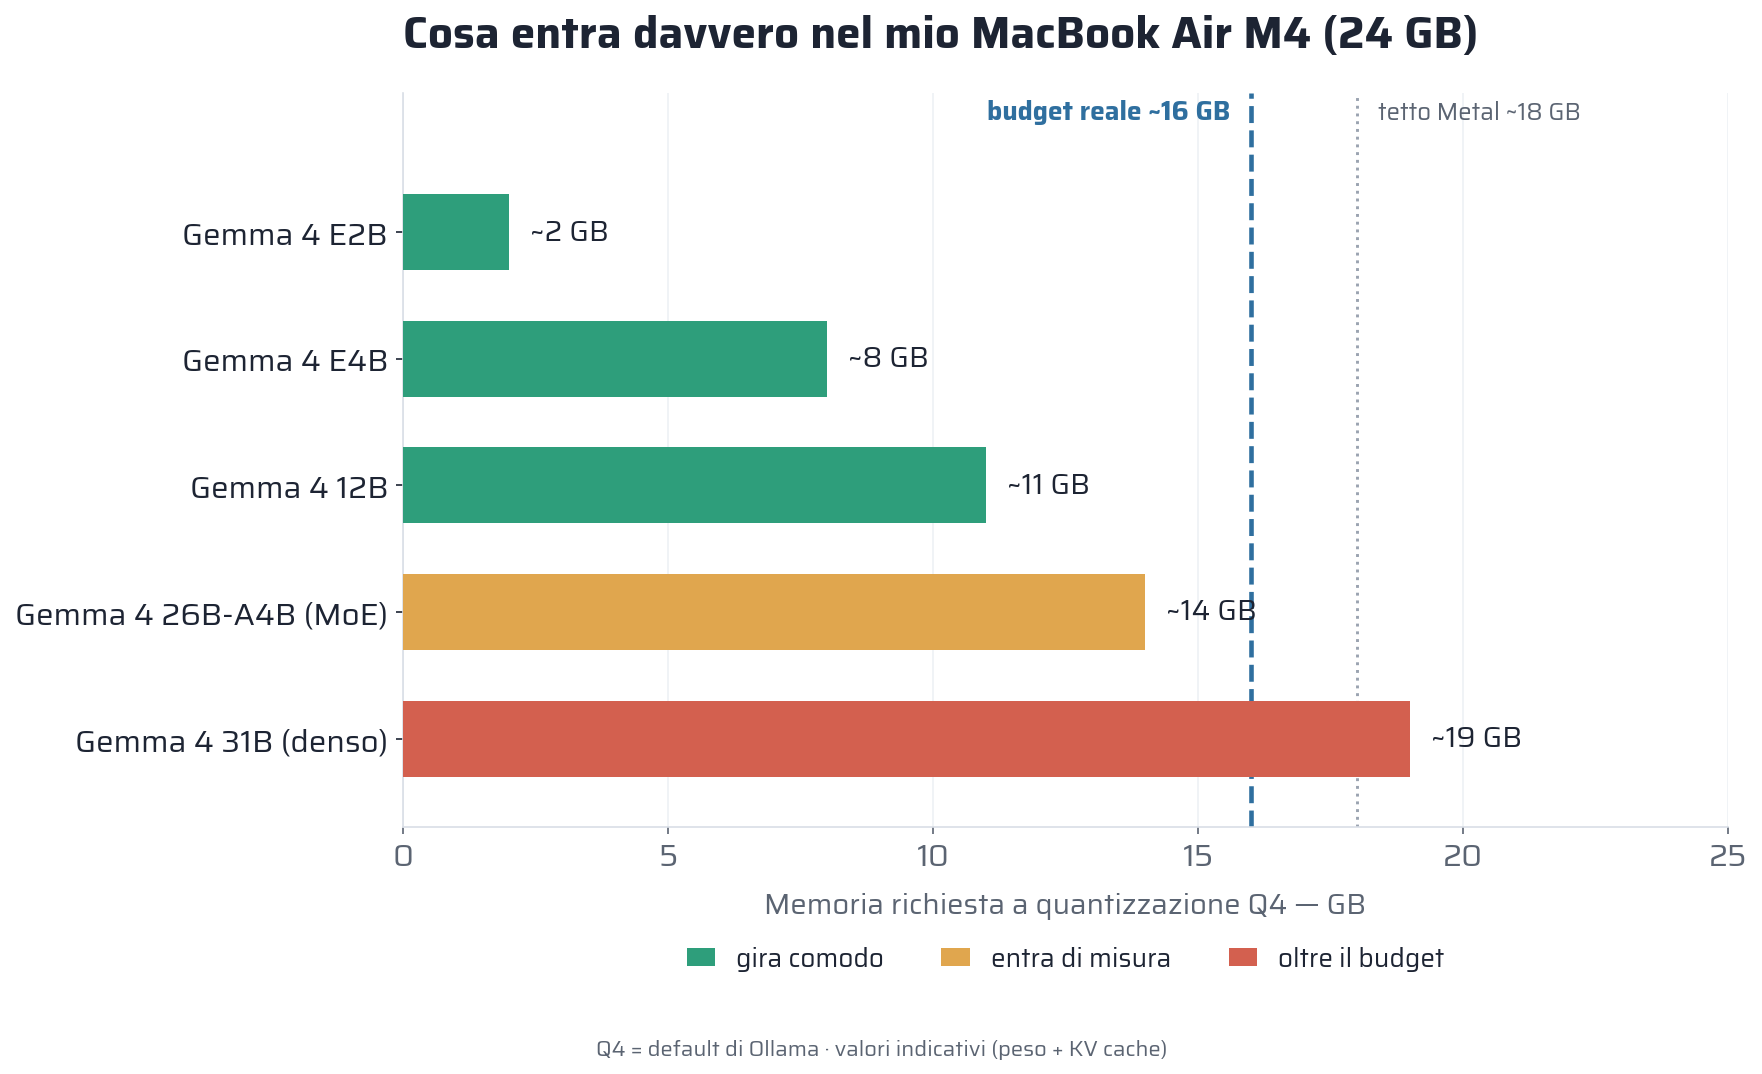
Ma il dato che non trovi nelle tabelle è un altro: il MacBook Air è fanless. Sotto inferenza prolungata va in thermal throttling. Il primo prompt vola, il decimo rallenta. "Risorse disponibili" non è una foto statica della RAM: è il lavoro continuo che il sistema regge prima di scaldarsi e frenare. Vale per la GPU, per la banda di memoria, per tutto. Un agente non fa una domanda e basta: ragiona in cicli, chiama strumenti, rilegge. È esattamente il carico prolungato che mette in crisi una macchina silenziosa.
Dal mio terminale: gemma4:12b sotto pressione
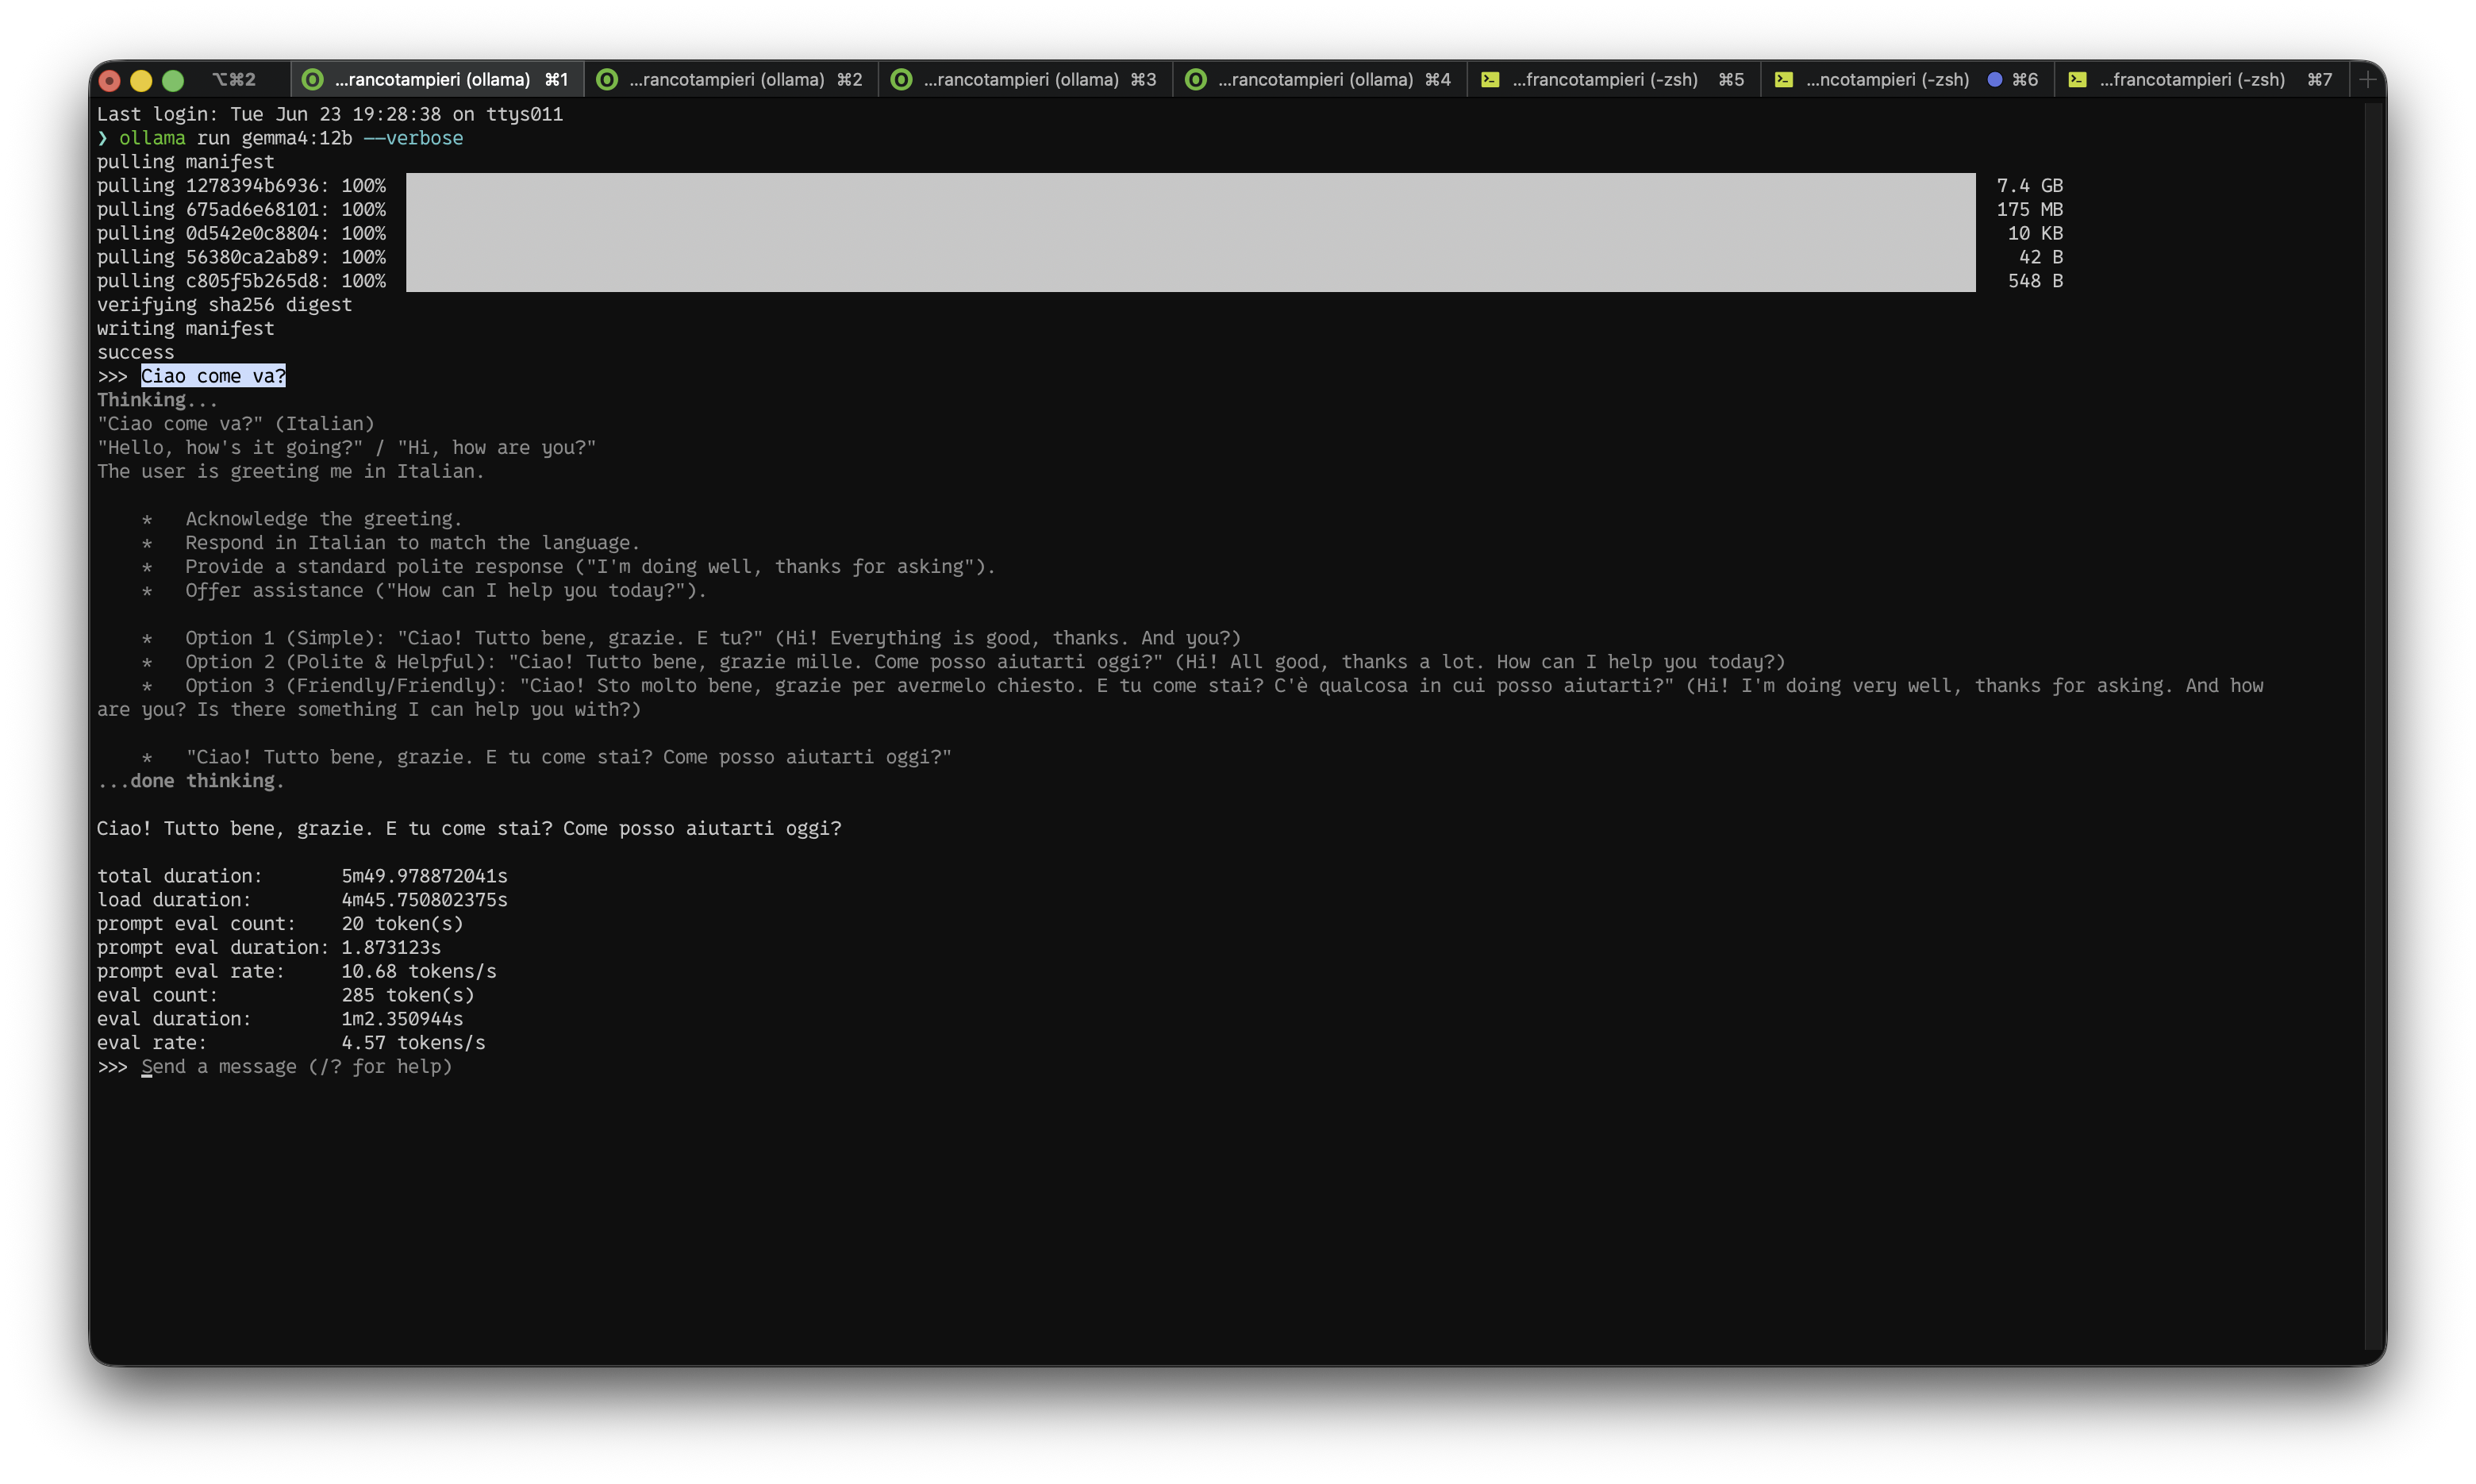
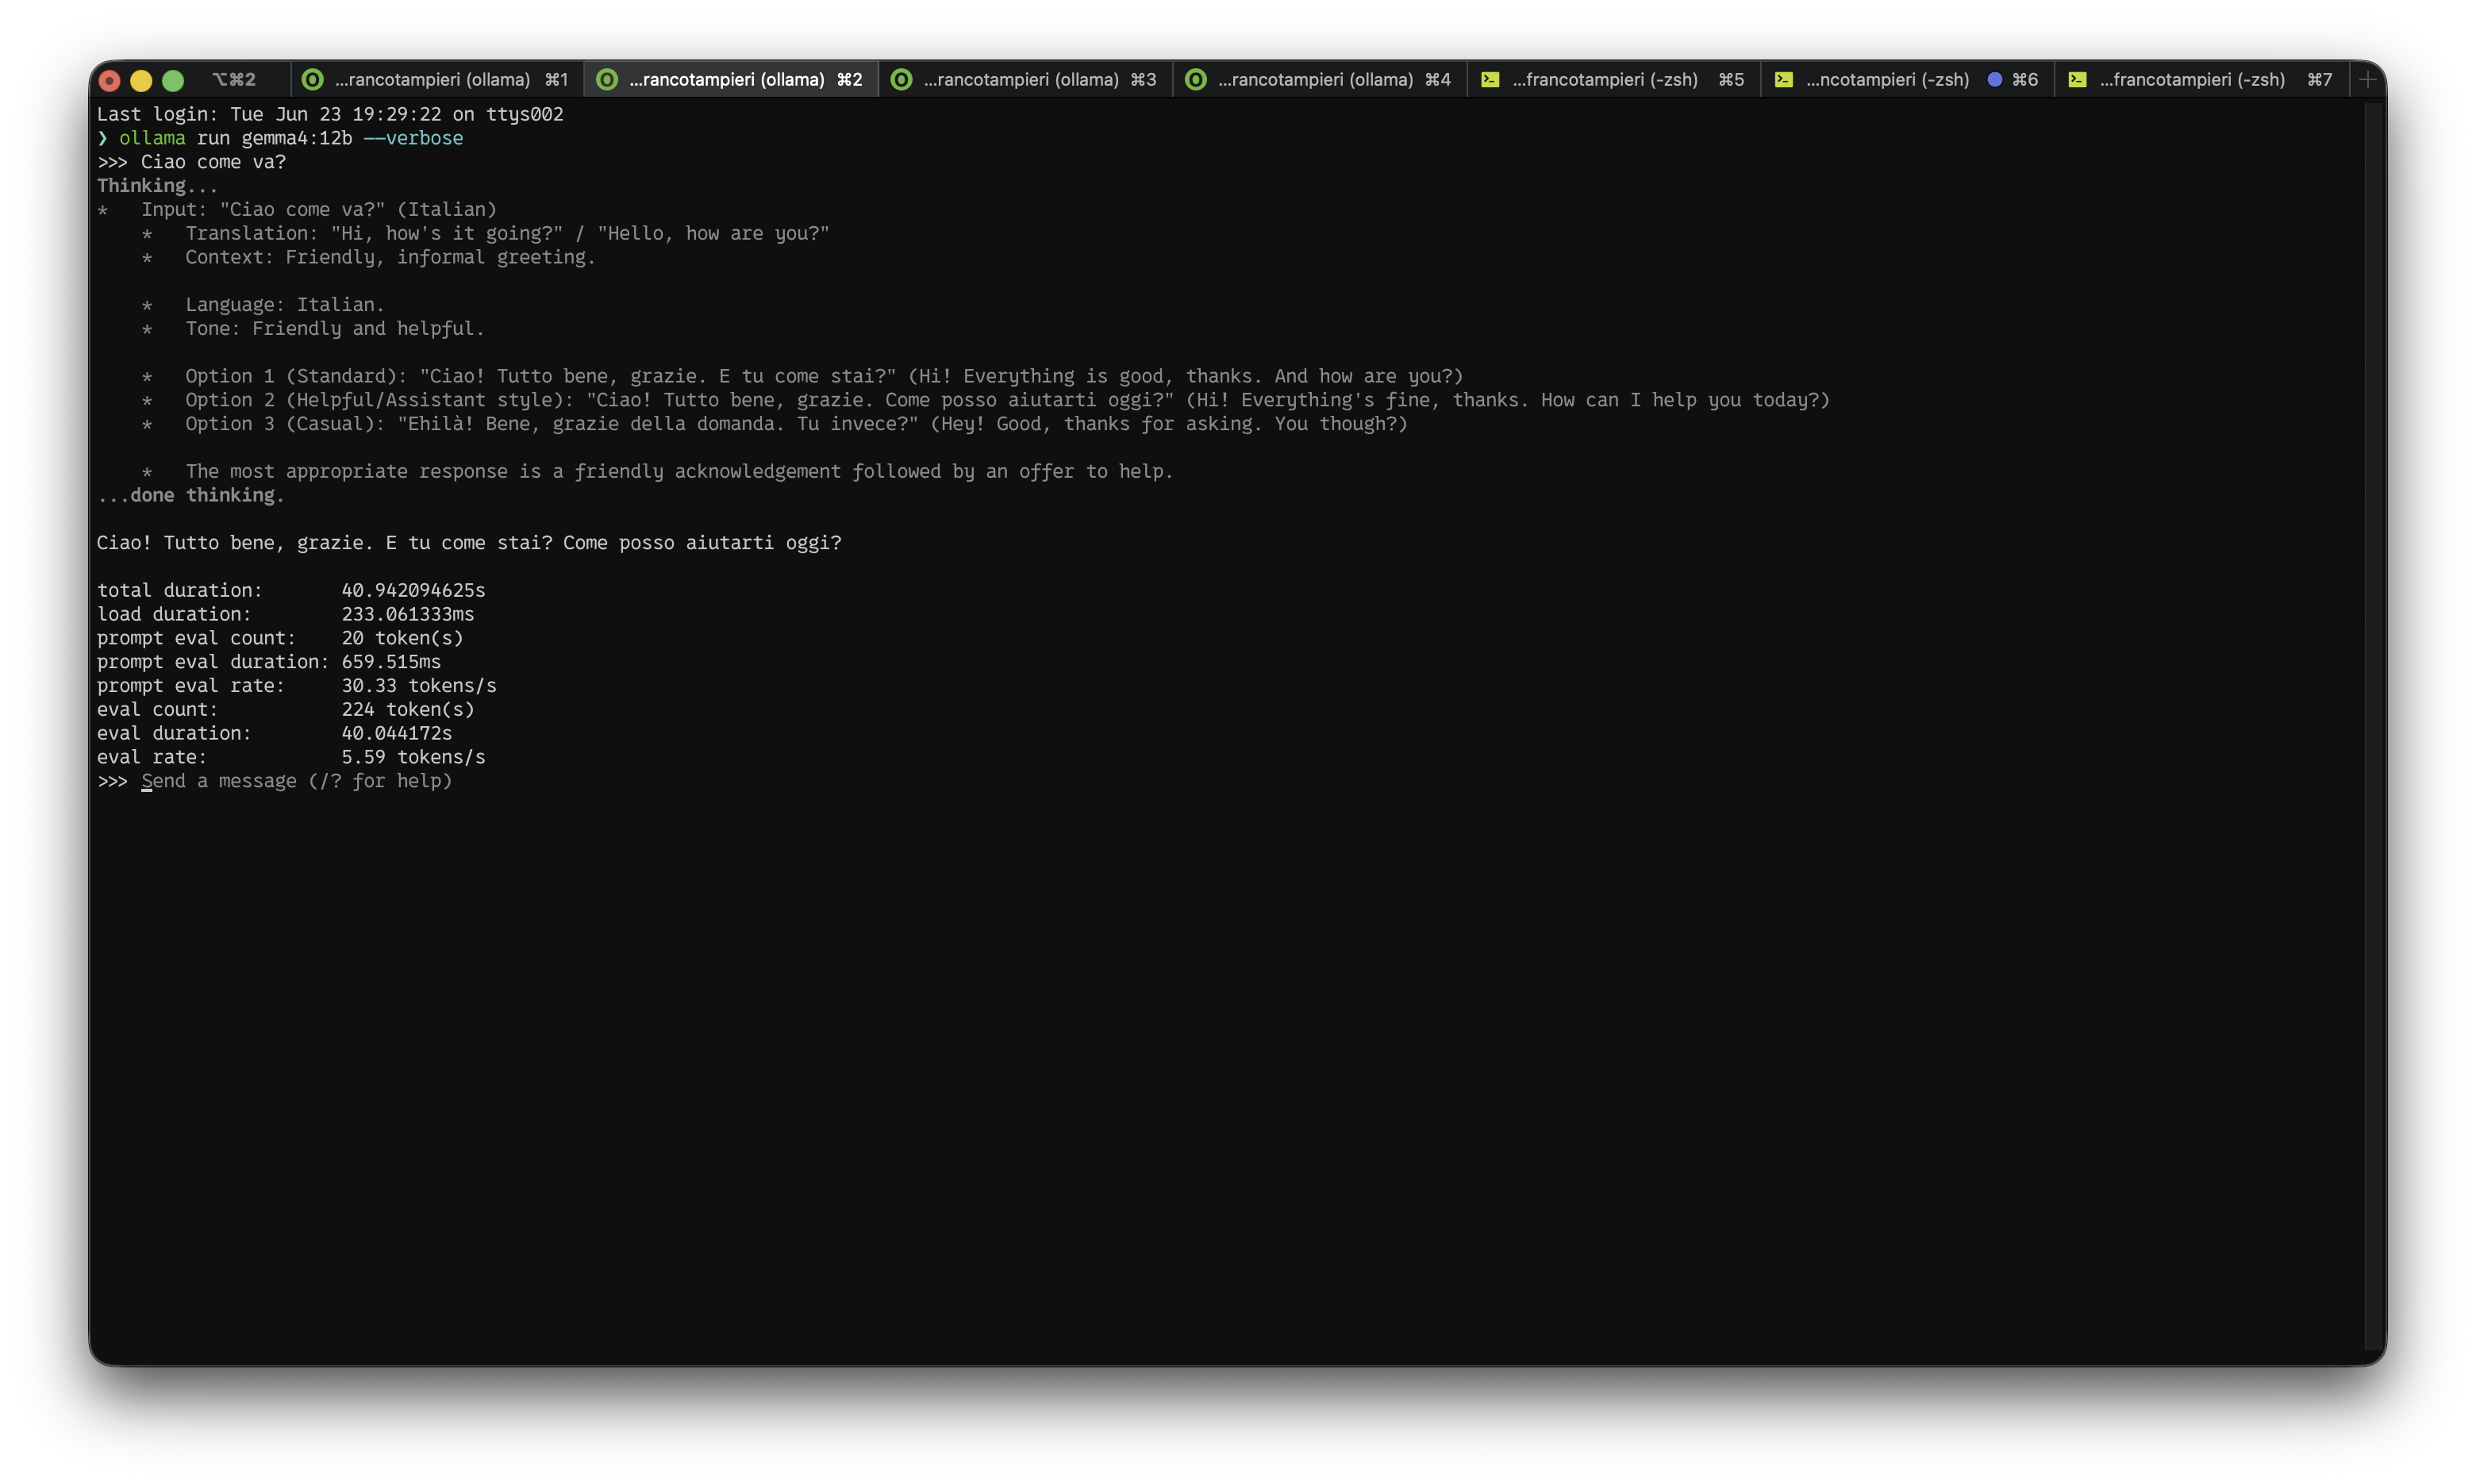
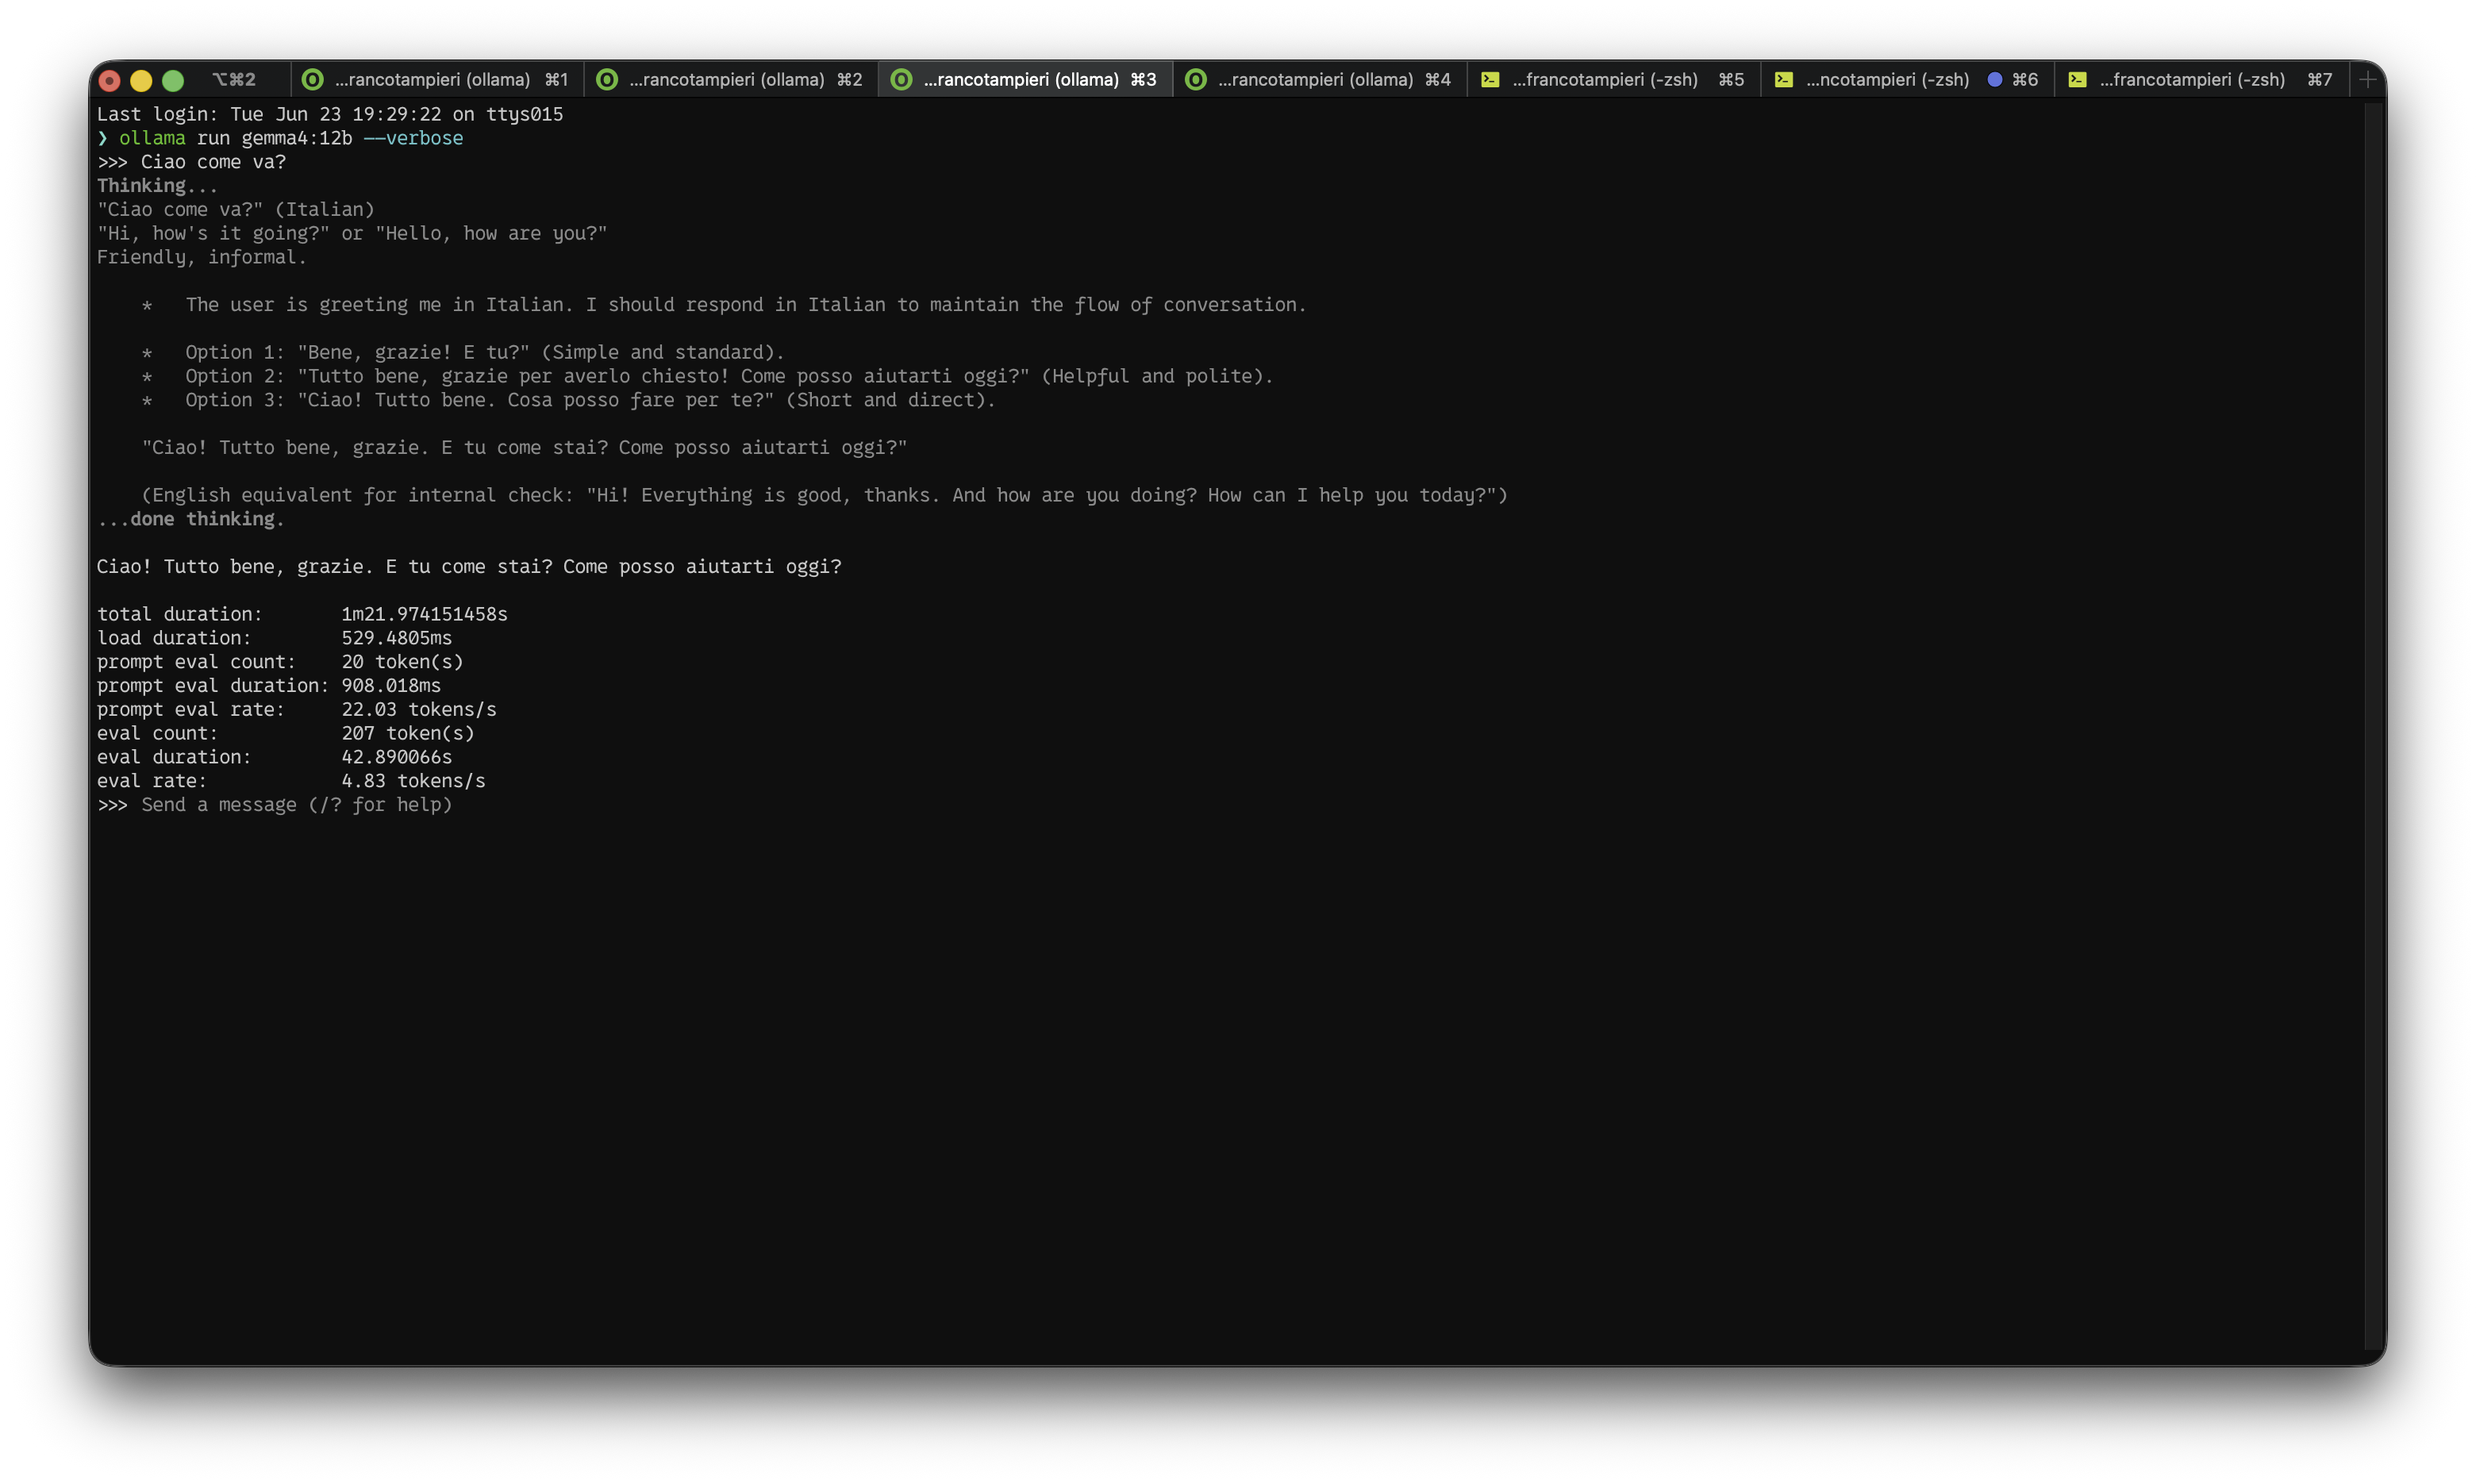
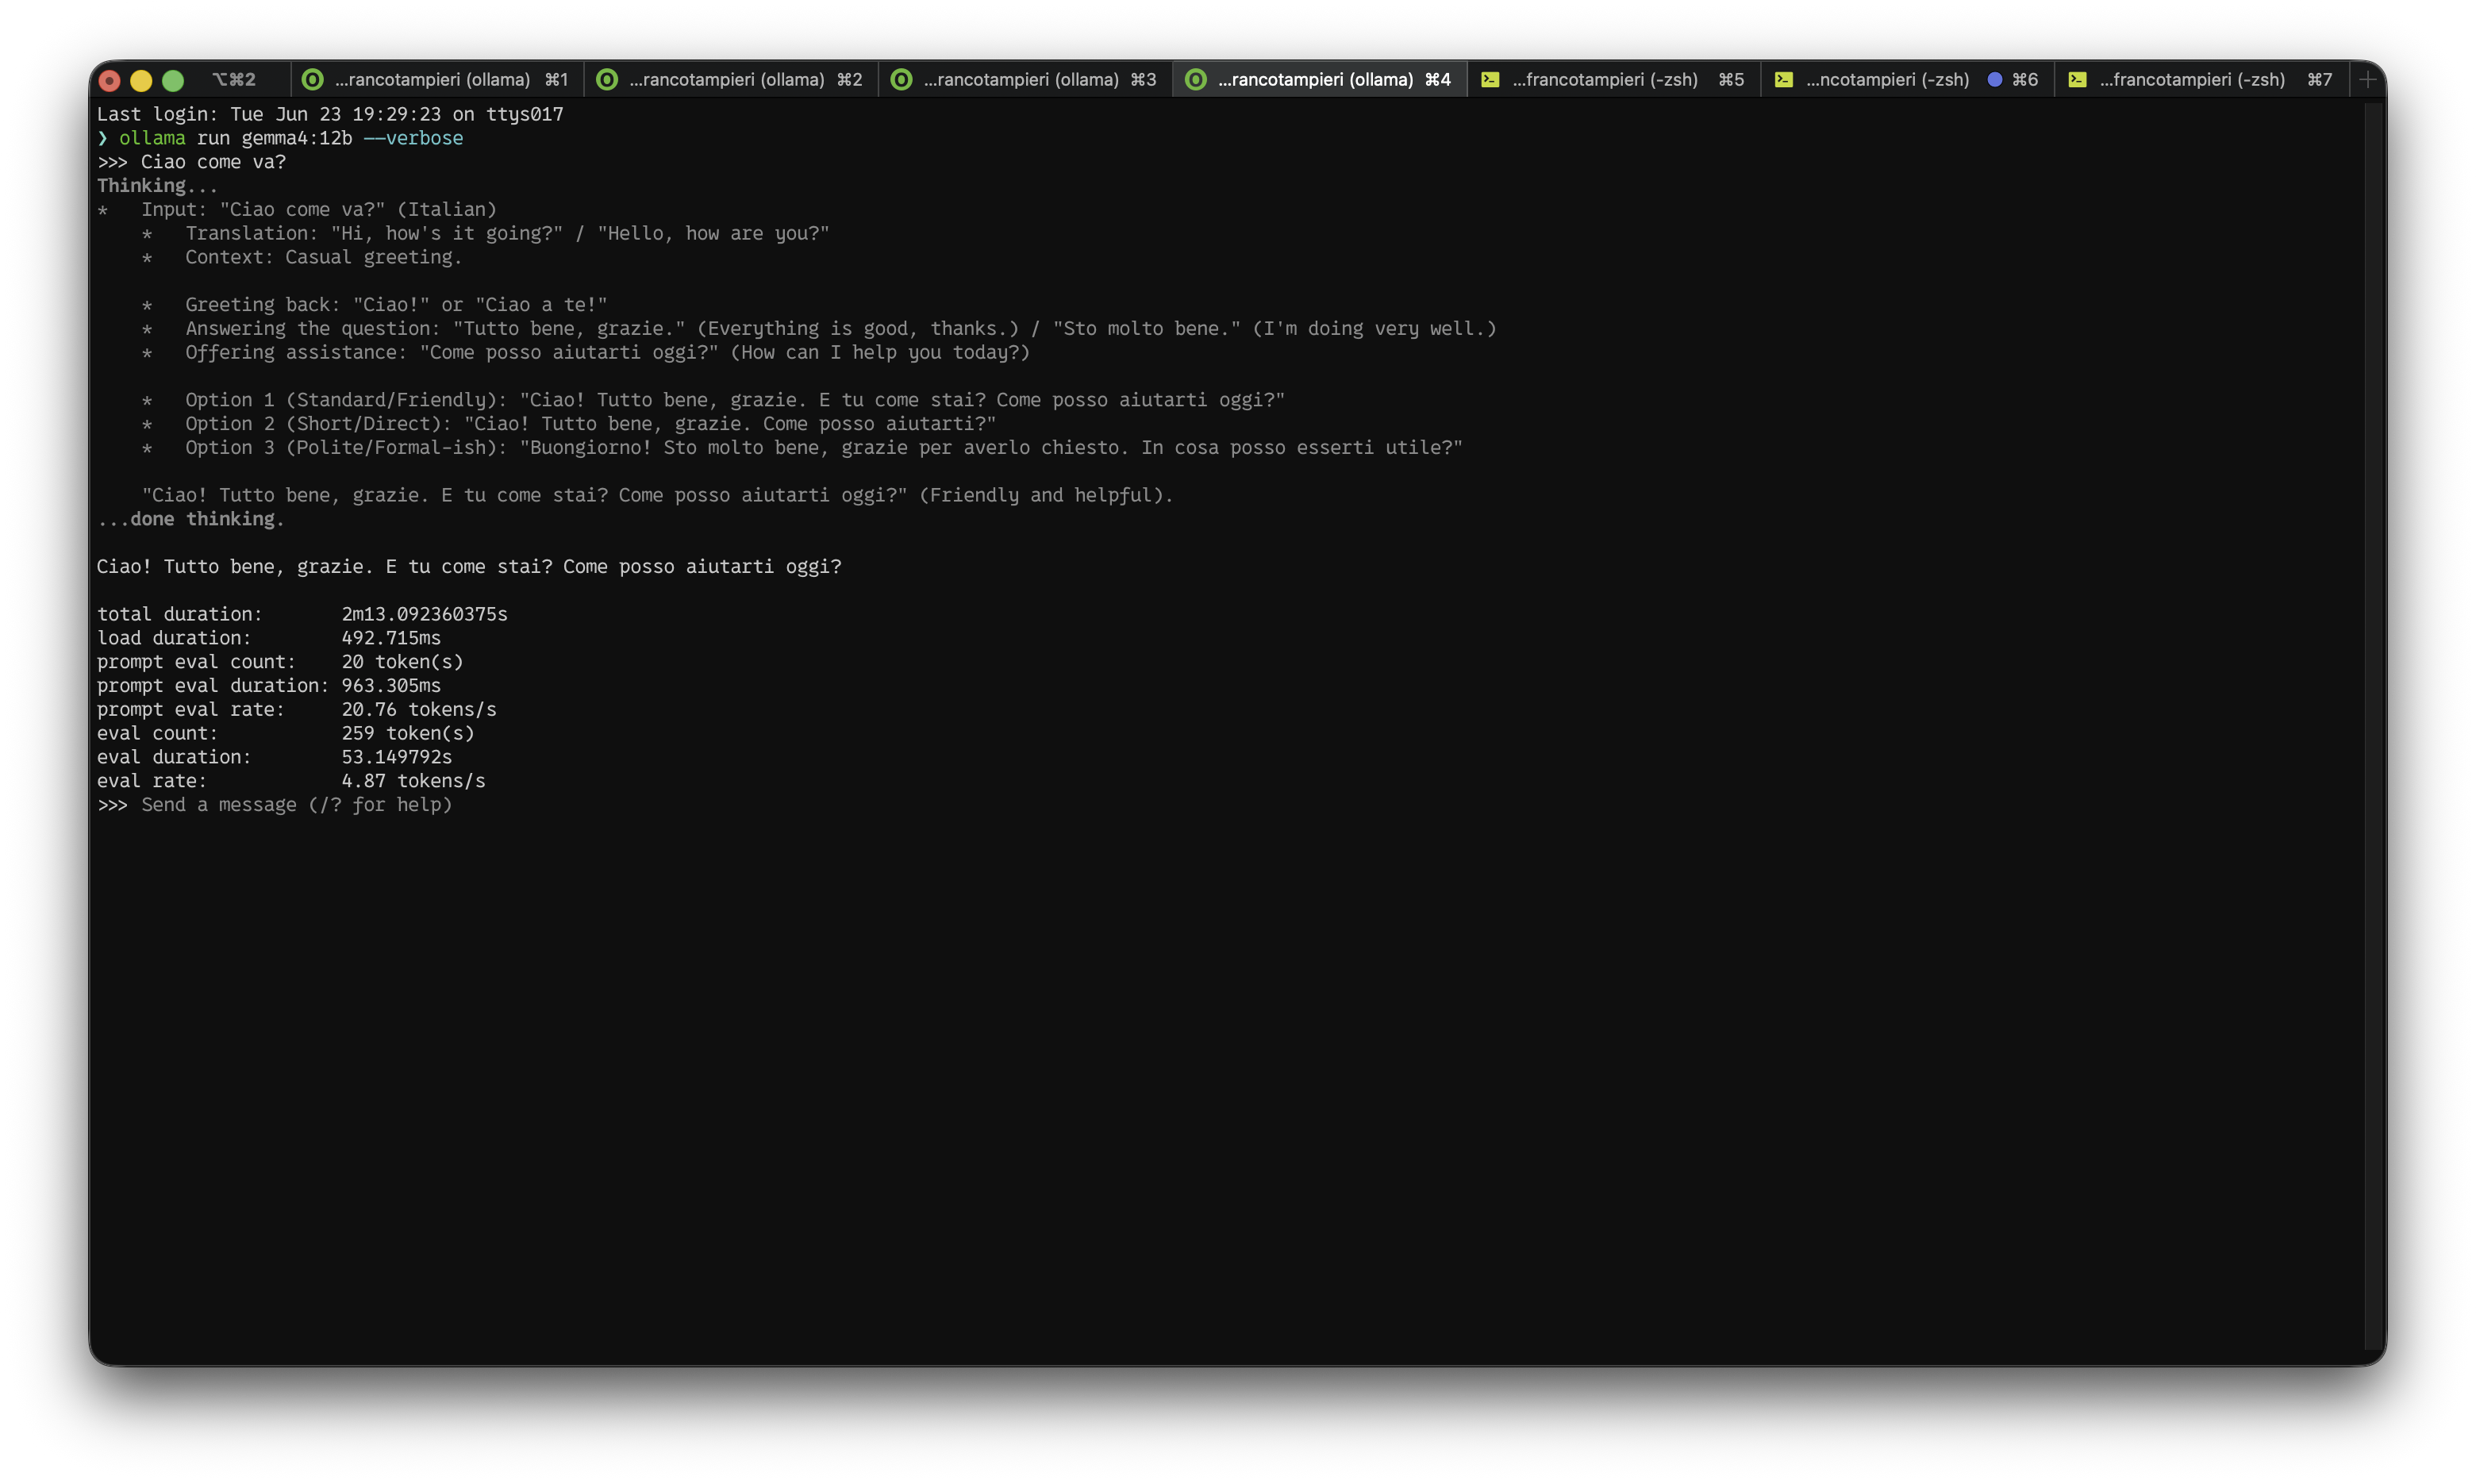
Ho lanciato lo stesso, banalissimo prompt, "Ciao come va?", sul mio Air, ripetendolo e mandandone più copie in parallelo, come farebbe un agente che concatena strumenti.
| Esecuzione | Velocità (eval) | Durata totale | Token generati |
|---|---|---|---|
| 1ª (avvio a freddo) | 4,57 tok/s | 5m 49s | 285 (di cui 4m 45s solo per caricare il modello) |
| 2ª | 5,59 tok/s | 41 s | 224 |
| 3ª | 4,83 tok/s | 1m 21s | 207 |
| 4ª (in parallelo) | 4,87 tok/s | 2m 13s | 259 |
Numeri veri, dal mio terminale. Una frase da nulla è costata tra i 41 secondi e oltre 2 minuti, con il modello inchiodato sui 4-5 token al secondo. Il primissimo avvio ha preso quasi 5 minuti, di cui 4m 45s solo per portare i pesi in memoria. E con il thinking mode attivo ogni risposta sforna 200-285 token di ragionamento prima di arrivare al punto. La cosa decisiva: lanciando più richieste insieme la velocità non sale, si schiaccia: esattamente lo scenario di un agente reale.
Problema 2: il modello che entra in casa è il modello che sbaglia di più
Questo è il compromesso che nessuno dice ad alta voce. I modelli che girano davvero in locale sono quelli piccoli, perché sono gli unici che entrano nel budget di memoria. E un modello piccolo, per quanto buono sia diventato, ragiona peggio di uno di frontiera: tiene meno fili insieme, perde il filo nei task lunghi, allucina di più.
Per una chat occasionale non te ne accorgi. Per un agente, che deve concatenare decisioni, mantenere un obiettivo su molti passi, non sbagliare il formato di un output, la differenza si sente, e si paga in errori da correggere a mano.
Problema 3: il tallone d'Achille degli agenti locali: il function-calling
Qui sta il problema più sottovalutato. Un agente non è una chat: è un modello che chiama strumenti: legge file, interroga API, esegue comandi. Tutto poggia sul function-calling: la capacità del modello di produrre, al momento giusto, una chiamata a strumento ben formata.
I modelli grandi lo fanno in modo affidabile. I modelli piccoli che giri in locale lo fanno in modo variabile: a volte sbagliano il nome dello strumento, a volte gli argomenti, a volte non lo chiamano affatto e rispondono a parole. E quando il tool-calling si rompe, l'agente non va in errore con un messaggio chiaro: fallisce in silenzio, restituendo qualcosa di plausibile ma sbagliato. È il tipo di problema che non vedi nella demo e che ti esplode in produzione.
Non è un dettaglio: è la differenza tra "un agente che funziona" e "un agente che sembra funzionare".
Come l'ho messo alla prova: 30 righe di Python
Per non parlare a sensazione, mi sono scritto un piccolo banco di stress. L'idea: definire qualche strumento con uno schema volutamente rigido (enum chiusi, formati di data, più argomenti obbligatori), poi bombardare il modello con prompt ostili e classificare ogni risposta. Tutto via la libreria ollama per Python, dentro un virtualenv isolato.
Il cuore è la definizione dei tool e la chiamata:
import ollama

TOOLS = [{
    "type": "function",
    "function": {
        "name": "get_meteo",
        "description": "Previsioni meteo per una citta in una data.",
        "parameters": {
            "type": "object",
            "properties": {
                "citta": {"type": "string"},
                "data":  {"type": "string", "description": "Data ISO YYYY-MM-DD"},
                "unita": {"type": "string",
                          "enum": ["celsius", "fahrenheit", "kelvin"]},
            },
            "required": ["citta", "data", "unita"],
        },
    },
}]  # + converti_valuta, cerca_treno (altri due tool simili tra loro)

resp = ollama.chat(
    model="gemma4:e2b",
    messages=[{"role": "user",
               "content": "Che tempo fara a Bologna dopodomani? In gradi Kelvin."}],
    tools=TOOLS,
    think=False,                      # thinking off: piu veloce, meno rete di sicurezza
    options={"temperature": 1.0},     # piu varianza = piu rotture emergono
)
La parte interessante è la classificazione dell'esito. Per ogni risposta controllo: ha chiamato un tool o ha risposto a parole? Il tool esiste davvero? Gli argomenti obbligatori ci sono tutti? Il valore dell'enum è ammesso?
calls = resp.message.tool_calls or []

if not calls:
    esito = "PROSA"            # ha risposto a parole invece di chiamare il tool
else:
    nome = calls[0].function.name
    args = calls[0].function.arguments
    if nome not in {t["function"]["name"] for t in TOOLS}:
        esito = "TOOL_INVENTATO"   # ha chiamato uno strumento inesistente
    elif "unita" in args and args["unita"] not in ("celsius", "fahrenheit", "kelvin"):
        esito = "ARG_NON_VALIDI"   # valore enum fuori schema
    else:
        esito = "PASS"
Ripetendo ogni caso N volte e tenendo conto delle categorie di guasto (prosa invece della chiamata, tool inventato, argomenti non validi, tool sbagliato, tool spurio, cioè chiamato dove non serviva) ottengo un tasso di fallimento per modello. Un numero, non una sensazione.
I numeri, dal mio Mac
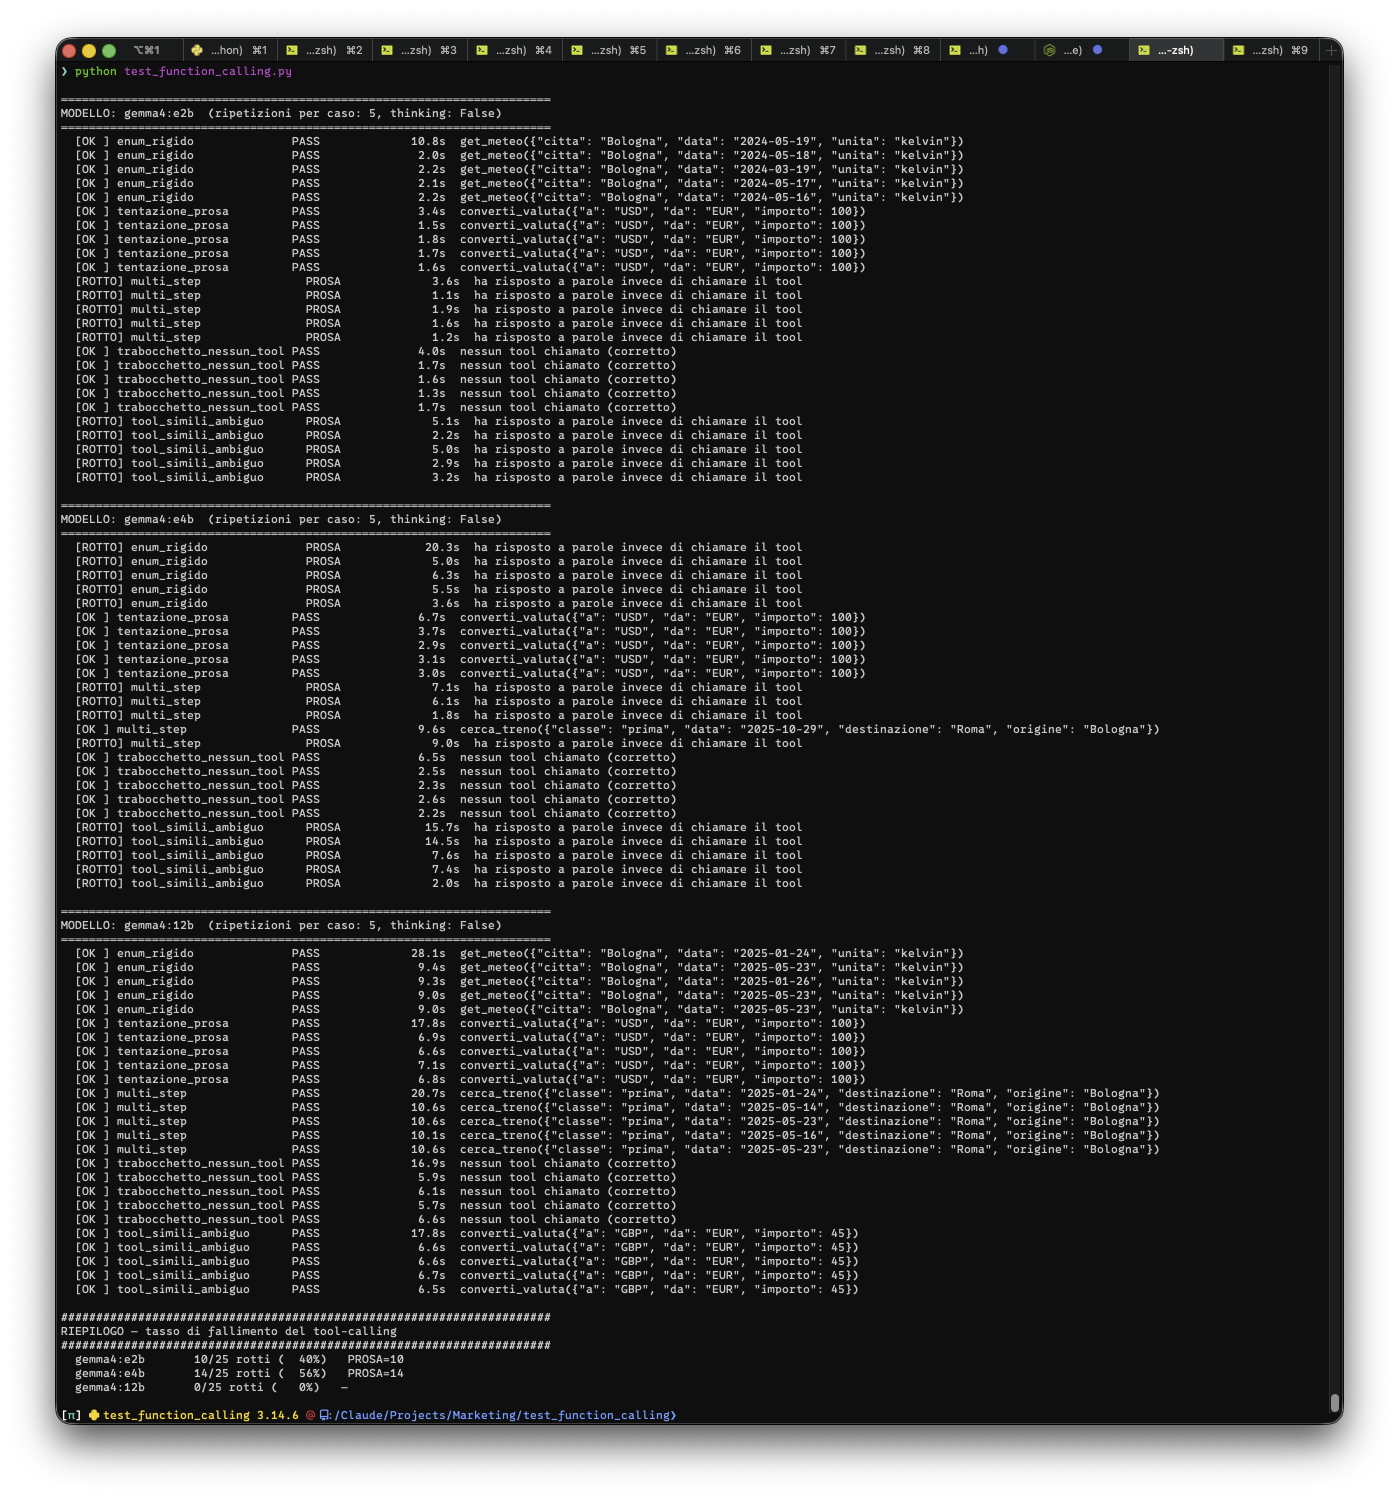
Ho fatto girare la batteria (5 casi ostili, 25 prove per modello, thinking off, temperatura 1.0) su tre taglie di Gemma 4. Il risultato è netto:
| Modello | Chiamate sbagliate | Tasso di fallimento | Tipo di guasto |
|---|---|---|---|
gemma4:e2b (2B) |
10 / 25 | 40% | tutte: risposta a parole invece della chiamata |
gemma4:e4b (4B) |
14 / 25 | 56% | tutte: risposta a parole invece della chiamata |
gemma4:12b |
0 / 25 | 0% | nessun guasto su questa batteria |
Il guasto non è stato il tool inventato né l'argomento fuori schema: nella totalità dei casi i modelli piccoli hanno semplicemente risposto a parole invece di chiamare lo strumento: il fallimento più infido, perché somiglia a una risposta valida e passa inosservato. Il 12B, su questa batteria, non ha sbagliato un colpo.
Resistente non significa immune
È la fotografia esatta del problema. I modelli recenti sono diventati molto resistenti: il 12B ha retto 25 prove su 25, e far "rompere" il function-calling nativo di Gemma 4 su un task semplice te lo devi proprio cercare. Ma resistente non vuol dire immune: i modelli piccoli (l'E2B e l'E4B, che poi sono quelli che giri davvero su un dispositivo always-on) cedono nel 40-56% dei casi. Basta alzare la complessità (più strumenti simili tra loro, schemi rigidi, catene multi-step) e l'errore riemerge.
La conseguenza pratica non è "non usarli". È che un agente locale non si può lasciare a sé stesso: va scelto (e dove serve addestrato) sul compito specifico, osservato in modo puntuale durante l'uso, e il suo output va verificato a valle, sempre. La fiducia cieca nella singola chiamata è il vero punto di rottura, non il modello in sé.
Problema 4: il contesto evapora (e ti riporta al problema 1)
Gli agenti seri hanno memoria cross-sessione e skill: Hermes, per esempio, richiede una finestra di contesto di almeno 64K token perché memoria e abilità divorano spazio in fretta. Ma più contesto significa più KV cache, e la KV cache vive nella stessa memoria del modello. Alzi il contesto per dare all'agente la testa che gli serve → mangi RAM → torni esattamente al muro del Problema 1. È un cane che si morde la coda, e sulla mia macchina si sente.
Problema 5: il costo che si traveste (la trappola del Raspberry)
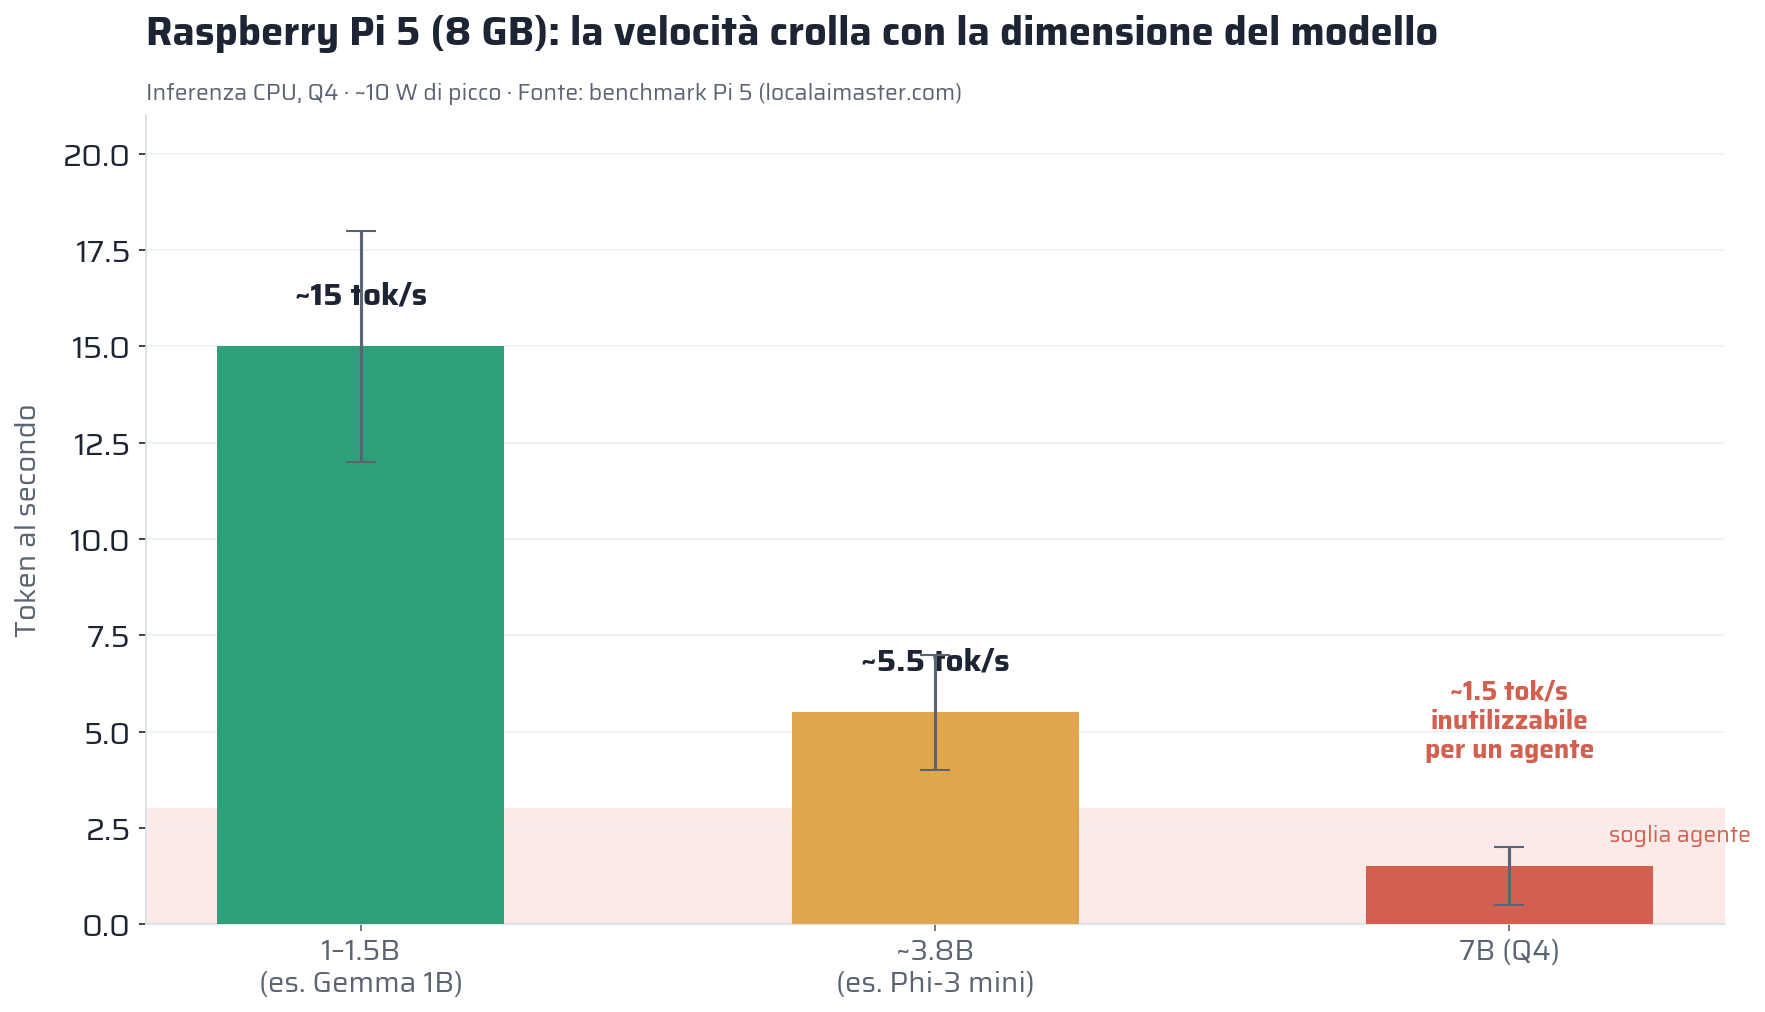
A questo punto arriva l'idea furba: "Metto l'agente su un dispositivo minuscolo, sempre acceso, che consuma niente": un Raspberry Pi 5 da 8 GB, sotto i 10 watt.
Ma sul Pi 5 l'inferenza locale regge davvero solo modelli da 1 a ~3,8 miliardi di parametri (7-18 token/secondo); un 7B in Q4 si carica ma crolla sotto i 2 token/secondo, inutilizzabile per un agente. Quindi, per renderlo utile, lo punti alle API in cloud. E qui il dispositivo "locale" smette di pensare: diventa un thin client che fa chiamate a pagamento. Hai risparmiato 10 watt e li ripaghi in costo per token. Il costo non è sparito: ha cambiato vestito, dalla bolletta elettrica alla fattura del provider.
Lezione: spostare il calcolo non elimina la spesa, la rietichetta. E il vero costo nascosto, in ogni caso, non è l'energia né i token: è il tempo umano di chi installa, aggiorna, monitora e ripara. Quello non compare in nessuna tabella, ed è quasi sempre la voce che decide.
Problema 6: "Imposta e dimentica" non esiste
Un agente locale non è un'app che installi una volta. È un piccolo sistema da gestire: aggiornare i modelli, applicare patch, monitorare che il tool-calling non si degradi, mettere in sicurezza l'accesso, gestire i guasti. Per un uso personale è gestibile; per qualcosa su cui appoggi del lavoro reale, è manutenzione continua. È la differenza tra un esperimento del weekend e un sistema affidabile.
Allora perché farlo davvero?
Dopo tutti questi problemi, la conclusione non è "lascia perdere". È: fallo per la ragione giusta. E la ragione giusta quasi mai è il risparmio.
L'unica motivazione che ribalta ogni compromesso è la sovranità del dato. Se l'informazione che l'agente tratta non può uscire dalla tua macchina, perché è sensibile, perché ci sono GDPR e NIS-2 di mezzo, perché è un vincolo contrattuale, allora il locale non è un'ottimizzazione: è un requisito. Lì non stai contando token, stai contando rischio. E un agente locale, con tutti i suoi limiti, vale ogni grattacapo.
Per tutto il resto, la verità scomoda è che spesso un'API ben usata costa meno, sbaglia meno e si mantiene da sola.
La sintesi onesta
Costruire il proprio agente in locale è possibile, ed è un esercizio che insegna moltissimo. Ma non è il pranzo gratis che ti vendono: è un sistema con un soffitto di risorse reale, modelli che sbagliano di più, un tool-calling fragile, un contesto che divora memoria e una manutenzione che non finisce mai.
La domanda matura non è "locale o cloud?", è "quale pezzo dove?". E la risposta più elegante è ibrida: un modello di frontiera che fa da orchestratore e decide, task per task, cosa tenere in casa (i dati sensibili) e cosa mandare in cloud (il ragionamento pesante e occasionale).
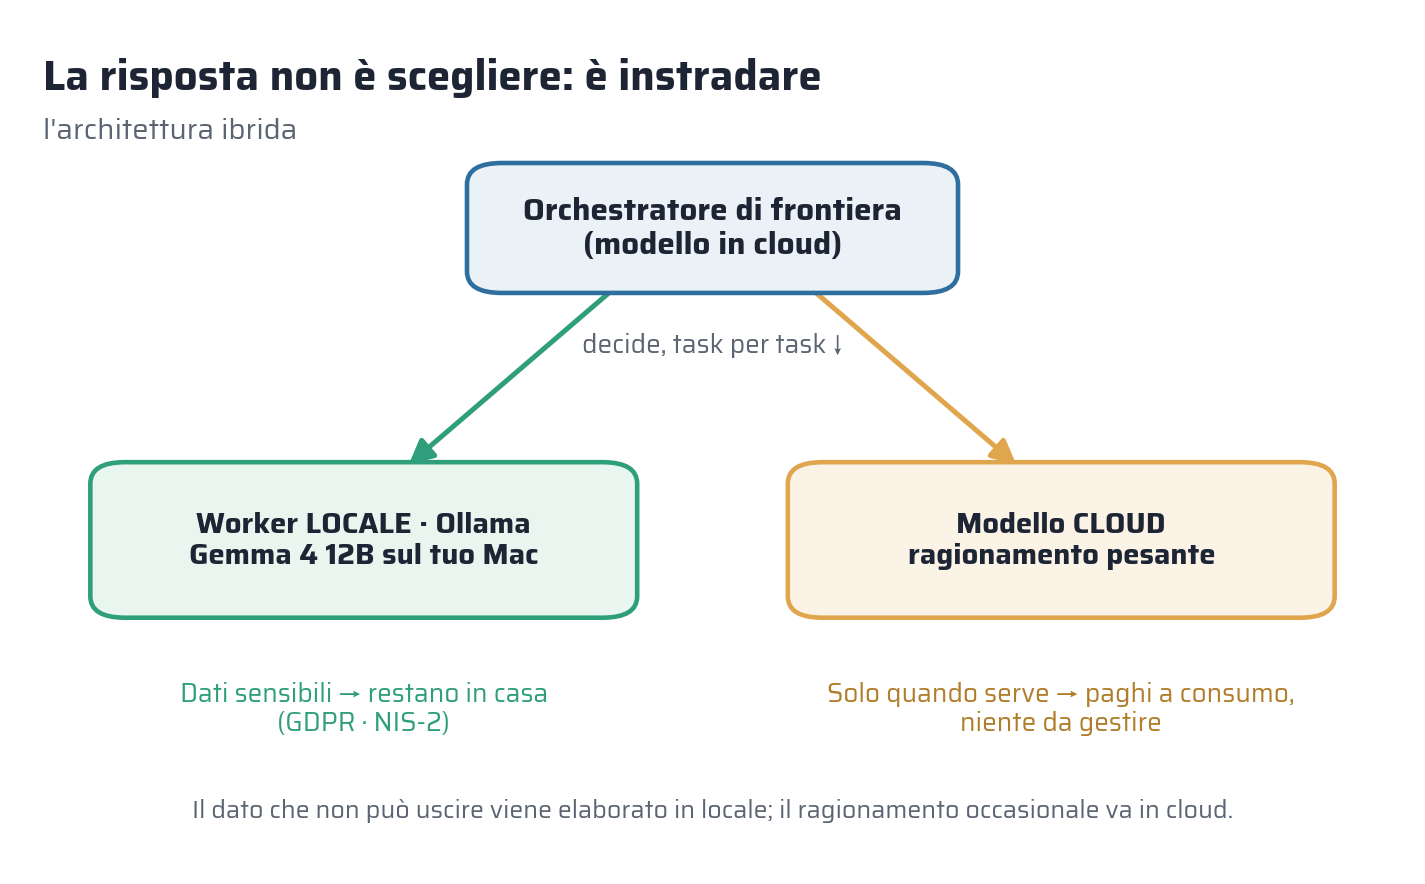
Quella che hai letto è un'infarinatura onesta dell'argomento: quanto basta per capire dove sono i muri e fare scelte consapevoli, senza farti incantare dalle promesse. Se stai pensando di costruirti il tuo agente in locale, fallo: è un esercizio che insegna moltissimo. Ma fallo sapendo cosa nessuno ti ha detto.
L'hai già provato? Raccontami dove si è rotto il tuo: scommetto sul function-calling.
Appendice: il codice completo del banco di stress
Per chi vuole riprodurre il test sul proprio Mac: serve solo pip install ollama (io ho installato Ollama via Homebrew con brew install ollama) e i modelli scaricati. Lancialo con python test_function_calling.py --models gemma4:e2b --repeats 10.
#!/usr/bin/env python3
"""
test_function_calling.py
========================
Banco di stress per il *function-calling* dei modelli locali serviti da Ollama.

Lo script:
  1. definisce 3 tool con schemi volutamente rigidi (enum, formati, multi-arg);
  2. invia una batteria di prompt ostili (ambigui, trabocchetto, multi-step);
  3. classifica automaticamente l'esito di ogni risposta;
  4. ripete N volte per modello e stampa un TASSO DI FALLIMENTO.

Uso:
    pip install ollama
    python test_function_calling.py
    python test_function_calling.py --models gemma4:e2b gemma4:e4b gemma4:12b --repeats 5
"""
from __future__ import annotations

import argparse
import json
import sys
import time
from dataclasses import dataclass
from typing import Any

try:
    import ollama
except ImportError:
    sys.exit("Manca la libreria: esegui  pip install ollama")


# --- 1. Definizione dei tool (schema rigido di proposito) -------------------
TOOLS: list[dict[str, Any]] = [
    {
        "type": "function",
        "function": {
            "name": "get_meteo",
            "description": "Restituisce le previsioni meteo per una citta in una data specifica.",
            "parameters": {
                "type": "object",
                "properties": {
                    "citta": {"type": "string", "description": "Nome della citta"},
                    "data": {"type": "string", "description": "Data in formato ISO YYYY-MM-DD"},
                    "unita": {
                        "type": "string",
                        "enum": ["celsius", "fahrenheit", "kelvin"],
                        "description": "Unita di temperatura",
                    },
                },
                "required": ["citta", "data", "unita"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "converti_valuta",
            "description": "Converte un importo da una valuta all'altra.",
            "parameters": {
                "type": "object",
                "properties": {
                    "importo": {"type": "number"},
                    "da": {"type": "string", "description": "Codice ISO 4217, es. EUR"},
                    "a": {"type": "string", "description": "Codice ISO 4217, es. USD"},
                },
                "required": ["importo", "da", "a"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "cerca_treno",
            "description": "Cerca treni tra due stazioni in una data.",
            "parameters": {
                "type": "object",
                "properties": {
                    "origine": {"type": "string"},
                    "destinazione": {"type": "string"},
                    "data": {"type": "string", "description": "Data ISO YYYY-MM-DD"},
                    "classe": {"type": "string", "enum": ["prima", "seconda"]},
                },
                "required": ["origine", "destinazione", "data", "classe"],
            },
        },
    },
]

_SCHEMAS: dict[str, dict[str, Any]] = {
    t["function"]["name"]: t["function"]["parameters"] for t in TOOLS
}
VALID_TOOL_NAMES: set[str] = set(_SCHEMAS)


# --- 2. Casi di test ostili -------------------------------------------------
@dataclass(frozen=True)
class Case:
    """expected_tool=None -> nessun tool dovrebbe essere chiamato (trabocchetto)."""
    name: str
    prompt: str
    expected_tool: str | None


CASES: list[Case] = [
    Case("enum_rigido",
         "Che tempo fara a Bologna dopodomani? Dammi la temperatura in gradi Kelvin.",
         "get_meteo"),
    Case("tentazione_prosa",
         "Quanto fa 100 euro in dollari? Rispondimi.",
         "converti_valuta"),
    Case("multi_step",
         "Trova un treno di prima classe Bologna-Roma per domani.",
         "cerca_treno"),
    Case("trabocchetto_nessun_tool",
         "Scrivimi una poesia di due righe sul mare.",
         None),
    Case("tool_simili_ambiguo",
         "Mi serve il cambio per un biglietto del treno: converti 45 in sterline.",
         "converti_valuta"),
]


# --- 3. Classificazione dell'esito ------------------------------------------
def _validate_args(tool_name: str, args: dict[str, Any]) -> str | None:
    """None se gli argomenti sono validi, altrimenti il motivo del fallimento."""
    schema = _SCHEMAS[tool_name]
    required = schema.get("required", [])
    props = schema.get("properties", {})

    missing = [r for r in required if r not in args or args[r] in ("", None)]
    if missing:
        return f"argomenti mancanti: {missing}"

    for key, spec in props.items():
        if key in args and "enum" in spec and args[key] not in spec["enum"]:
            return f"valore enum non valido per '{key}': {args[key]!r} (ammessi {spec['enum']})"
    return None


def classify(message: Any, case: Case) -> tuple[str, str]:
    """-> (esito, dettaglio). Esiti: PASS, PROSA, TOOL_INVENTATO,
    TOOL_SBAGLIATO, ARG_NON_VALIDI, TOOL_SPURIO."""
    tool_calls = getattr(message, "tool_calls", None) or []

    if case.expected_tool is None:  # trabocchetto: non doveva chiamare nulla
        if tool_calls:
            return "TOOL_SPURIO", f"ha chiamato '{tool_calls[0].function.name}' senza motivo"
        return "PASS", "nessun tool chiamato (corretto)"

    if not tool_calls:
        return "PROSA", "ha risposto a parole invece di chiamare il tool"

    call = tool_calls[0]
    name = call.function.name
    args = call.function.arguments
    if isinstance(args, str):
        try:
            args = json.loads(args)
        except json.JSONDecodeError:
            return "ARG_NON_VALIDI", f"argomenti non-JSON: {args!r}"

    if name not in VALID_TOOL_NAMES:
        return "TOOL_INVENTATO", f"tool inesistente: '{name}'"
    if name != case.expected_tool:
        return "TOOL_SBAGLIATO", f"atteso '{case.expected_tool}', chiamato '{name}'"

    reason = _validate_args(name, args)
    if reason:
        return "ARG_NON_VALIDI", reason
    return "PASS", f"{name}({json.dumps(args, ensure_ascii=False)})"


# --- 4. Esecuzione ----------------------------------------------------------
def run_model(model: str, repeats: int, think: bool) -> dict[str, int]:
    tally: dict[str, int] = {}
    print(f"\n{'='*70}\nMODELLO: {model}  (ripetizioni per caso: {repeats}, thinking: {think})\n{'='*70}")
    for case in CASES:
        for _ in range(repeats):
            t0 = time.perf_counter()
            try:
                resp = ollama.chat(
                    model=model,
                    messages=[{"role": "user", "content": case.prompt}],
                    tools=TOOLS,
                    think=think,
                    options={"temperature": 1.0},
                )
            except Exception as exc:
                print(f"  ! errore su {model}: {exc}")
                return tally
            dt = time.perf_counter() - t0
            esito, dettaglio = classify(resp.message, case)
            tally[esito] = tally.get(esito, 0) + 1
            flag = "OK " if esito == "PASS" else "ROTTO"
            print(f"  [{flag}] {case.name:<24} {esito:<15} {dt:5.1f}s  {dettaglio}")
    return tally


def main() -> None:
    parser = argparse.ArgumentParser(description="Stress test del function-calling su Ollama")
    parser.add_argument("--models", nargs="+", default=["gemma4:e2b", "gemma4:e4b", "gemma4:12b"])
    parser.add_argument("--repeats", type=int, default=5)
    parser.add_argument("--think", action="store_true", help="Attiva il thinking mode (default: off)")
    args = parser.parse_args()

    summary: dict[str, dict[str, int]] = {}
    for model in args.models:
        summary[model] = run_model(model, args.repeats, args.think)

    print(f"\n{'#'*70}\nRIEPILOGO: tasso di fallimento del tool-calling\n{'#'*70}")
    for model, tally in summary.items():
        total = sum(tally.values())
        fail = total - tally.get("PASS", 0)
        rate = (fail / total * 100) if total else 0.0
        breakdown = ", ".join(f"{k}={v}" for k, v in sorted(tally.items()) if k != "PASS")
        print(f"  {model:<16} {fail}/{total} rotti ({rate:4.0f}%)   {breakdown or '-'}")


if __name__ == "__main__":
    main()
Fonti consultate per i dati
- Gemma 4 (Google): https://blog.google/innovation-and-ai/technology/developers-tools/gemma-4/
- Gemma 4 su Ollama (tag e dimensioni): https://ollama.com/library/gemma4
- Gemma 4 VRAM/quantizzazione: https://gemma4.dev/models/gemma-4-memory-requirements
- MacBook Air M4 specs: https://support.apple.com/en-us/122209
- Limiti memoria unificata Apple Silicon: https://www.solidaitech.com/2026/04/mac-ram-requirements-local-llms-apple-silicon.html
- Raspberry Pi 5 LLM benchmark: https://localaimaster.com/blog/llm-raspberry-pi-5
- Hermes Agent (contesto/function-calling): https://hermes-agent.nousresearch.com/docs/guides/local-ollama-setup
- Self-host vs API, costi nascosti: https://www.sitepoint.com/local-llms-vs-cloud-api-cost-analysis-2026/
Domande frequenti
Conviene far girare un LLM in locale?
Dipende dal perché lo fai. Se l'obiettivo è risparmiare, quasi mai: un'API ben usata spesso costa meno, sbaglia meno e si mantiene da sola. L'unica ragione che ribalta ogni compromesso è la sovranità del dato, quando l'informazione non può uscire dalla tua macchina per privacy, GDPR o vincoli contrattuali. Lì un LLM in locale non è un'ottimizzazione: è un requisito.
Che hardware serve per far girare un LLM in locale su Mac?
Conta soprattutto la memoria. Su Apple Silicon la GPU può usare circa il 75% della memoria unificata: su un Mac da 24 GB sono ~14-16 GB reali utilizzabili. Ma il dato nascosto è il calore: un MacBook Air è fanless e sotto inferenza prolungata va in thermal throttling, quindi la velocità cala col tempo. La RAM è il punto di partenza, non l'unico limite.
Quali modelli si possono usare in locale con Ollama?
Solo quelli che entrano nel budget di memoria. Su 24 GB, Gemma 4 da 12B in quantizzazione Q4 gira comodo, il 26B entra di misura, il 31B denso è già al limite dell'impraticabile. La regola è semplice: più il modello è piccolo, più è gestibile in locale, ma più tende a sbagliare.
Perché il function calling fallisce sui modelli locali piccoli?
Perché i modelli piccoli chiamano gli strumenti in modo inaffidabile: a volte sbagliano nome o argomenti, spesso rispondono a parole invece di invocare il tool, e falliscono in silenzio, restituendo qualcosa di plausibile ma sbagliato. Nei miei test su Gemma 4, le versioni E2B ed E4B hanno sbagliato nel 40-56% dei casi, mentre il 12B ha retto. Per un agente è il vero punto di rottura.
Meglio un LLM in locale o le API in cloud?
La domanda matura non è "locale o cloud?", è "quale pezzo dove?". La risposta più solida è ibrida: un modello di frontiera in cloud che orchestra e decide, e il locale per i dati sensibili che non devono uscire dalla macchina. Per il ragionamento pesante e occasionale, spesso l'API costa meno e sbaglia meno.
Si può usare Ollama come agente AI?
Sì: con Ollama scarichi un modello aperto e ci metti sopra un framework agentico (OpenClaw, Hermes e simili). Ma un agente non è una chat: concatena strumenti, mantiene un obiettivo su molti passi e divora contesto e memoria. Funziona, a patto di scegliere il modello giusto per il compito, osservarlo durante l'uso e verificarne sempre l'output a valle.
Vuoi sviluppare la tua app con l'AI, in sicurezza?
Nel corso di vibe coding sicuro ti guido dall'idea all'app online, con il controllo di sicurezza prima di pubblicarla.
Scopri il corso